Taisymas · · 5 min. skaitymo · Lurto · Atnaujinta
n8n workflow nuolat lūžta: priežasties ieškokite ne raudoname mazge
Trumpas atsakymas
Raudonas mazgas n8n parodo, kur gedimas išryškėjo, bet ne kur jis prasidėjo: priežastis dažniausiai būna keliais mazgais aukščiau arba visai už n8n ribų. Atlikite keturis patikrinimus iš eilės: perskaitykite visą klaidos atsakymą ir jo būsenos kodą, palyginkite vykdymus prieš gedimą ir po jo, užfiksuokite įvesties duomenis ir paleiskite mazgą atskirai, nustatykite datą, kada gedimai prasidėjo. Tada pasirūpinkite, kad gedimas nesikartotų: kartokite bandymą esant 429 ir 5xx, bet niekada esant 400 ar 401, nustatykite klaidų workflow, kuris įspėja žmogų, tikrai skaitantį pranešimus, ir padarykite pakartotinius paleidimus saugius, prieš kuriant įrašą patikrindami, ar jis jau yra, arba naudodami upsert.
Atidarote n8n ir vėl matote raudoną mazgą vykdymų sąraše. Paleidžiate iš naujo rankiniu būdu, viskas veikia, uždarote skirtuką. Po dviejų dienų jis vėl lūžta, tik šįkart atlikęs pusę darbo: sukūrė kontaktą CRM ir sustojo, kol dar nebuvo išsiųstas el. laiškas. Dabar turite dubliuotą kontaktą ir klientą, kuris taip ir negavo atsakymo.
Tokios būklės workflow taisome beveik kiekvieną savaitę. Priežastys kartojasi. Toliau aprašome tvarką, kuria ieškome priežasties, ir ką pakeičiame, kad gedimas nebesikartotų.
Kodėl Jūsų n8n workflow nuolat lūžta realiame darbe
Dažniausia pirma klaida yra laikyti lūžtantį mazgą pačia problema. Kas nors pamato, kad HTTP Request mazgas meta klaidą, įjungia Continue On Fail ir eina toliau. Dabar workflow baigiasi sėkme, nors daro ne tai, ką turėtų. Tai blogiau nei atvira klaida, nes į sėkmingą vykdymą niekas nežiūri.
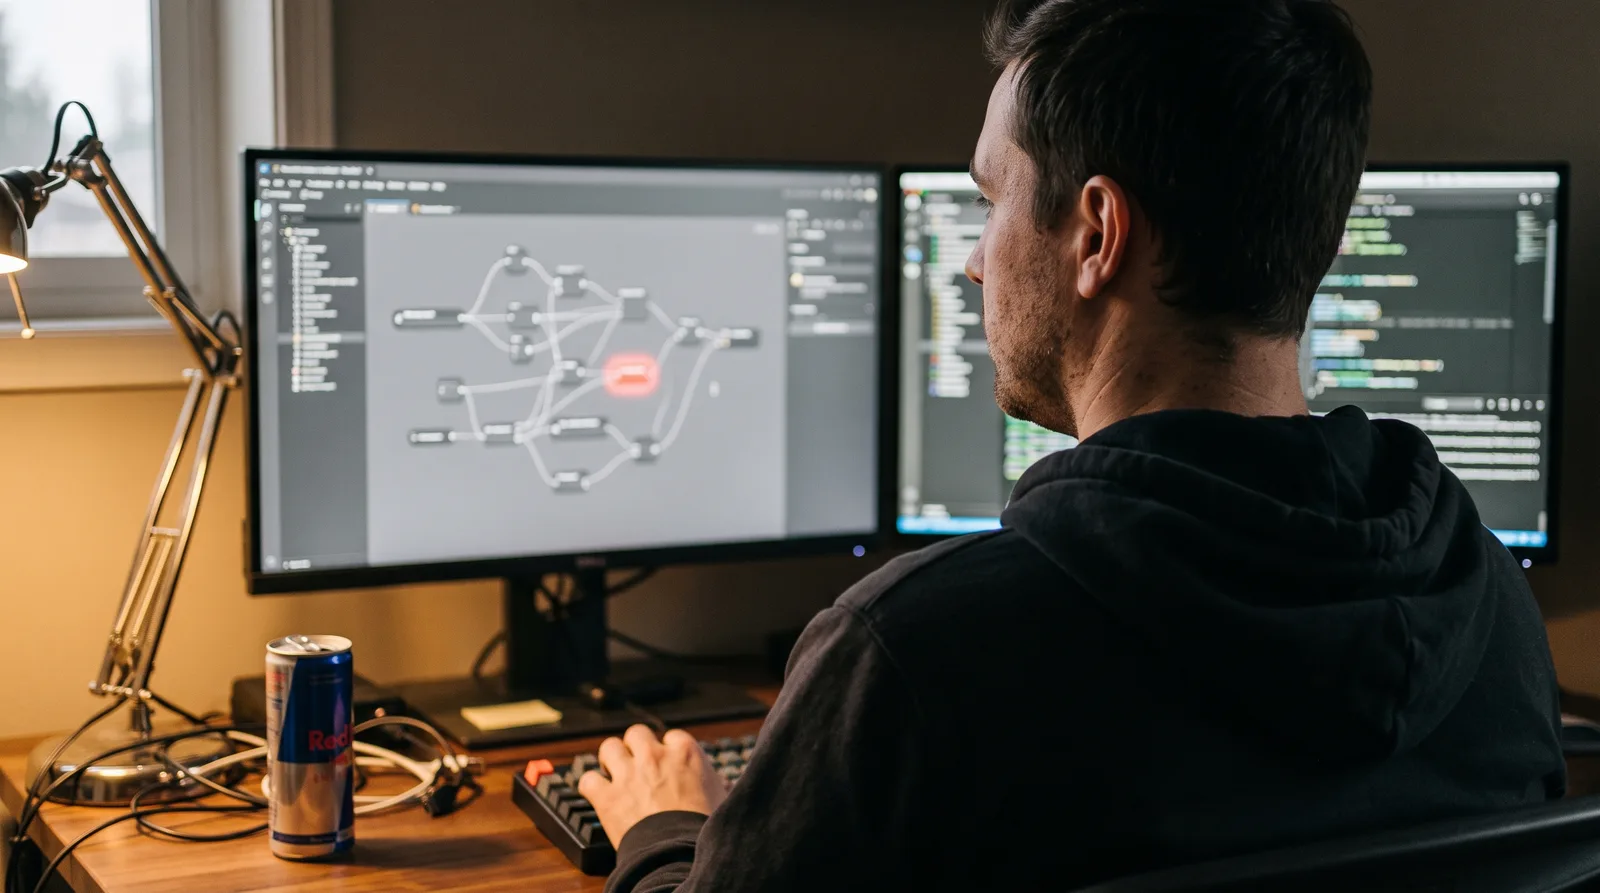
Raudonas mazgas parodo, kur gedimas išryškėjo. Priežastis dažniausiai būna keliais mazgais aukščiau arba visai už n8n ribų.
Sugedusiose sistemose, kurias esame vertinę, vis kartojasi tos pačios kelios priežastys. Išorinės API kartais sutrinka, kad ir kaip gerai jos sukurtos, o workflow be pakartotinių bandymų kiekvieną trumpą sutrikimą paverčia nepavykusiu vykdymu. Vienas mūsų peržiūrėtas potencialių klientų paskirstymo workflow lūždavo maždaug kartą per dieną iš apie 200 vykdymų, o vienintelis jo įspėjimas keliaudavo į Slack kanalą, suarchyvuotą prieš kelis mėnesius, todėl niekas nebuvo matęs nė vieno gedimo.
Webhook laiko limitai yra antroji didelė priežastis. Workflow atlieka sunkų darbą pačiame webhook kelyje, siuntėjas po 30 sekundžių nustoja laukti, pažymi pristatymą kaip nepavykusį ir dažnai bando dar kartą, todėl be gedimo gaunate dar ir dublikatų. Atsakykite iš karto, o apdorokite atskirame vykdyme.
Dar yra pakeitimų, kurių niekas nesieja su workflow:
- Paslaugų teikėjas nustojo palaikyti API adresą (endpoint). Jis veikė metus, o vieną antradienį pradėjo grąžinti 410, nors Jūsų pusėje niekas nieko nelietė, ir būtent todėl niekas ten neieškojo.
- Kas nors iš pardavimų komandos pervadino CRM lauką arba ištrynė pardavimų etapą.
- Buvo atšauktas OAuth tokenas arba kolega pakeitė bendrą slaptažodį. Šis atvejis bent jau pasirodo kaip 401, jei kas nors skaito žurnalą.
- Išaugo srautas. Workflow, kuris apdorodavo 50 įrašų per dieną, ties 500 gauna 429, o n8n užklausų dažnio ribojimą laiko tokiu pačiu gedimu kaip bet kurį kitą. Split In Batches ciklas per 10 000 elementų su pilnais JSON duomenimis ilgainiui išnaudoja visą serverio atmintį, o kadangi tai priklauso nuo to, kiek duomenų atkeliavo tą dieną, gedimas atrodo atsitiktinis.
Keturi patikrinimai, prieš keičiant mazgą
- Perskaitykite klaidos tekstą. Raudonas ženklelis nieko nepasako. Atidarykite nepavykusį vykdymą, spustelėkite lūžtantį mazgą ir perskaitykite visą atsakymą. 401 reiškia prisijungimo duomenis. 404 arba 410 reiškia pasikeitusį API adresą arba ištrintą įrašą. 429 reiškia užklausų dažnio ribojimą. Laiko limito viršijimas visai be atsakymo reiškia tinklo problemą arba perkrautą išorinę paslaugą. Vien būsenos kodas atmeta pusę galimų priežasčių.
- Pažiūrėkite į gretimus vykdymus. Atsidarykite vykdymus prieš pat gedimą ir po jo. Jei tas pats mazgas su panašia įvestimi 09:12 suveikė, o 09:13 lūžo, problema yra išorinėje paslaugoje, ir sprendimas yra pakartotinis bandymas.
- Išbandykite mazgą atskirai. Prisekite (pin) nepavykusio vykdymo įvesties duomenis ir paleiskite tik tą mazgą. Jei jis lūžta su prisegtais duomenimis, problema yra mazge arba išorinėje paslaugoje. Jei suveikia, vadinasi, realiame darbe į jį patenka kitokie duomenys, nei manote, ir reikia palyginti prisegtus duomenis su sėkmingu vykdymu prieš mėnesį.
- Nustatykite datą. Jei gedimai prasidėjo konkrečią dieną, tą dieną kažkas ir pasikeitė. Pasiteiraukite, ar kas nors keitė CRM nustatymus, pakeitė raktą, atnaujino n8n, ar paslaugų teikėjas išleido API pakeitimą. Perskaitykite teikėjo pakeitimų sąrašą (changelog). Dauguma staigių gedimų, dėl kurių mus kviečia, atsekami iki pakeitimo, kurio niekas nesiejo su workflow.
Kad gedimas nesikartotų
Ištaisę tik konkrečią klaidą, grįžtate prie tos pačios trapios sistemos. Dar viena darbo valanda, ir workflow nebetrukdys Jums kiekvieną savaitę. Pakartotiniai bandymai, nepavykusių įrašų eilė (dead letter) ir įspėjimas, kurį skaito žmogus, yra pirmieji punktai kontroliniame sąraše, kurį pateikiame klientams prieš paleidžiant sistemą.
Įjunkite retry on fail kiekvienam HTTP Request mazgui, kuris kreipiasi į išorinę paslaugą, su 3-5 bandymais ir ilgėjančia pertrauka tarp jų. Kartokite esant 429 ir 5xx. Nekartokite esant 400 ar 401; tokie bandymai niekada nepavyks, o pakartojimai tik uždelsia įspėjimą.
Nustatykite klaidų workflow. n8n gali paleisti atskirą workflow įvykus bet kokiam gedimui, ir jis turėtų užfiksuoti workflow pavadinimą, vykdymo URL, mazgą ir klaidos pranešimą, o tada nusiųsti tai ten, kur žmogus žiūri kasdien. Mūsų išvada, sutvarkius kelias dešimtis tokių atvejų: žurnalai be įspėjimų beveik nieko neverti, ir tai antroji iš šešių priežasčių, kodėl automatizacijos nustoja veikti po paleidimo. Kiekviena įmonė, kreipusis į mus po mėnesio tylių gedimų, turėjo žurnalus. Nė viena neturėjo įspėjimo, kurį gautų žmogus.
Padarykite pakartotinius paleidimus saugius. Prieš kurdami įrašą patikrinkite, ar jis jau egzistuoja, pagal ką nors stabilaus, pavyzdžiui, el. pašto adresą ar išorinį ID, arba naudokite upsert operaciją, jei mazgas ją siūlo. Kai pakartotinis paleidimas nebegali sukurti dublikatų, nepavykusį vykdymą pakartoti galima vienu paspaudimu.
Žinokite, kada sustoti
Jei žurnalas rodo vieną aiškią priežastį, visa tai, kas aprašyta aukščiau, telpa į vieną popietę. Ne visada taip būna. Sustokite ir kreipkitės pagalbos, kai gedimai pasitaiko protarpiais ir be jokio dėsningumo, kai workflow išaugo daugiau nei iki 40 ar 50 mazgų ir niekas negali atsekti, kaip per jį juda įrašas, arba kai pataisius vieną mazgą nuolat išlenda naujas gedimas dviem mazgais toliau. Tai architektūros problemos: taisant po vieną raudoną mazgą, workflow tik dar labiau susipainioja. Kartais teisingas sprendimas yra kurti iš naujo, o tai, ar sugedusią automatizaciją taisyti, ar kurti iš naujo, aprašome diagnostikoje, užuot išrašę sąskaitą už dar vieną laikiną pataisymą.
Jei prieš išleisdami pinigus norite, kad kas nors dar kartą pažiūrėtų, atliekame raštišką diagnostiką už 450 €. Per dvi darbo dienas gaunate dokumentą, kuriame įvardyta, kas lūžta ir kodėl, ir fiksuota taisymo kaina, o 450 € įskaitomi į tą kainą. Dauguma n8n taisymų kainuoja nuo 700 iki 1 400 € ir užtrunka 2-5 dienas, su 30 dienų klaidų garantija. Pradėkite nuo mūsų sugedusių sistemų taisymo paslaugos arba atsiųskite mums simptomus.
Dažnai užduodami klausimai
Ar įjungti Continue On Fail, kad klaidos liautųsi?
Ne. Tada workflow baigiasi sėkme, nors daro ne tai, ką turėtų, o tai blogiau nei atvira klaida, nes į sėkmingą vykdymą niekas nežiūri. Lūžtantis mazgas yra ta vieta, kur problema išryškėjo, o ne kur ji prasidėjo.
Ką mums pasako klaidos būsenos kodas?
Pakankamai, kad dar nieko nelietę atmestumėte pusę galimų priežasčių. 401 reiškia prisijungimo duomenis. 404 arba 410 reiškia pasikeitusį API adresą (endpoint) arba ištrintą įrašą. 429 reiškia užklausų dažnio ribojimą. Laiko limito viršijimas visai be atsakymo reiškia tinklo problemą arba perkrautą išorinę paslaugą. Vien raudonas ženklelis nieko nepasako: atidarykite nepavykusį vykdymą ir perskaitykite visą atsakymo turinį.
Kodėl metus gerai veikęs workflow staiga pradėjo lūžti?
Jei gedimai prasidėjo konkrečią dieną, tą dieną kažkas ir pasikeitė. Paslaugų teikėjas nustojo palaikyti API adresą ir vieną antradienį pradėjo grąžinti 410. Kas nors iš pardavimų komandos pervadino CRM lauką arba ištrynė pardavimų etapą. Buvo atšauktas OAuth tokenas. Arba tiesiog išaugo srautas: srautas, kuris apdorodavo 50 įrašų per dieną, ties 500 gauna 429, o Split In Batches ciklas per 10 000 elementų su pilnais duomenimis ilgainiui išnaudoja visą serverio atmintį, todėl gedimas atrodo atsitiktinis.
Kokią pakartotinių bandymų politiką nustatyti?
Retry on fail kiekvienam HTTP Request mazgui, kuris kreipiasi į išorinę paslaugą, nuo trijų iki penkių bandymų su ilgėjančia pertrauka tarp jų. Kartokite esant 429 ir 5xx. Nekartokite esant 400 ar 401: tokie bandymai niekada nepavyks, o pakartojimai tik uždelsia įspėjimą. Tada nustatykite klaidų workflow, kuris užfiksuoja workflow pavadinimą, vykdymo URL, mazgą ir klaidos pranešimą ir siunčia juos ten, kur žmogus žiūri kasdien. Žurnalai be įspėjimų beveik nieko neverti.
Kada nustoti taisyti patiems ir kreiptis pagalbos?
Kai gedimai pasitaiko protarpiais ir be jokio dėsningumo, kai workflow išaugo daugiau nei iki 40 ar 50 mazgų ir niekas negali atsekti, kaip per jį juda įrašas, arba kai pataisius vieną mazgą nuolat išlenda naujas gedimas dviem mazgais toliau. Tai architektūros problemos: taisant po vieną raudoną mazgą, workflow tik dar labiau susipainioja.
Daugiau apie taisymą
Jūsų sistema veikia ne taip, kaip turėtų?